В выпуске за 4 ноября шесть новых исследований, впервые представленных 3 ноября: экономия ресурсов ИИ-агентов через частое сжатие контекста, регулирование нагрузки дата-центров маршрутизацией запросов, автоматизированное создание обучающих данных для роботов, вычислительная оптимизация антител, программная инфраструктура полностью шифрованного вывода моделей и защита агентов от подмены параметров. Наиболее непосредственные инженерные возможности связаны с управлением памятью агентов, нагрузкой GPU и проверкой аргументов инструментов. Робототехнический результат включает испытания на физическом устройстве; показатели энергетической гибкости получены в моделировании. Все шесть источников — исследования авторов от 3 ноября, без независимого промышленного подтверждения универсальности результатов.
Длинный контекст больше не единственный способ сохранить ход работы
Группа Питера Белчака в препринте от 3 ноября сообщает, что частое сжатие контекста в исследованных задачах длинного горизонта позволяет моделям выполнять работу без существенного падения качества относительно сохранения полной истории.
Новая работа Питера Белчака и соавторов ставит под сомнение распространённое инженерное предположение: чем длиннее история диалога в контексте модели, тем лучше агент выполняет сложный проект. Исследователи сравнили режимы накопления всей истории с частым сжатием промежуточных состояний в задачах длительного программирования и обработки объёмного ввода. По их данным, в изученных сценариях короткий актуальный контекст позволял сохранять результативность, близкую к работе с полной историей. Это экспериментальная оценка рабочих схем, а не доказательство ненужности больших окон для любых задач.
Практическая ценность результата связана с ценой каждого следующего токена: длинная накопленная история увеличивает вычислительную нагрузку, особенно при многократных шагах агента. Если исполнитель умеет надёжно выносить решения, ограничения и результаты проверок в компактное состояние, то вычислительные ресурсы расходуются на новую работу, а не на повторное чтение всех предыдущих действий. Для сервисов, где агент ежедневно возвращается к одной базе знаний или к одному репозиторию, это открывает перспективу многоэтапной работы с управляемыми затратами.
Однако компрессия не является безусловной заменой памяти. Теряться могут редкие исключения, точные формулировки требований, зависимости между событиями и контекст безопасности. Следующий значимый этап — не ещё один рекорд длины окна, а воспроизводимые испытания того, какие факты и обязательства нельзя терять между действиями.
“frontier language models sacrifice little to no task accuracy when maintaining short contexts.”You don't need long context
Возможности
- Снижение объёма обрабатываемой истории при длительной работе агентов и в сервисах на основе больших языковых моделей.
- Создание проверяемых структурированных состояний проекта вместо повторного чтения полного протокола.
Ограничения
- При компрессии можно потерять редкие требования, исключения и долгосрочные обязательства агента.
- Результаты зависят от класса задач, качества алгоритма сжатия и базовых моделей.
Новое исследование опубликовано 3 ноября 2026 года, то есть накануне выпуска. В доступных выпусках за 30 октября — 3 ноября это событие не зафиксировано; работа Prefrontal от 2 ноября касалась механизма внимания, а не экспериментальной проверки частого сжатия истории.
Гибкое энергопотребление ИИ-центров без массового переноса запросов
Патель и соавторы предложили регулировать энергопотребление ИИ-инференса распределением запросов между экземплярами моделей; в симуляции центра с 10 000 H100 наблюдалась гибкость до 16% общей мощности.
Шивам Патель и соавторы предложили управлять потреблением энергии серверной инфраструктуры через маршрутизацию пользовательских запросов между экземплярами языковых моделей. Система стремится менять распределение работы так, чтобы укладываться в допустимую мощность и не прекращать интерактивное обслуживание.
В опубликованном исследовании модель проверялась на четырёх GPU-платформах и языковых моделях от 1 до 70 миллиардов параметров. Более крупный сценарий — имитация дата-центра с 10 000 ускорителей H100 на основе трасс реальной нагрузки. В этой симуляции потенциальная гибкость достигала 16% общего энергопотребления, а 90% требуемого снижения мощности достигалось примерно за десять секунд. Это результат моделирования, не свидетельство промышленного внедрения такого регулятора в действующей энергосистеме.
Значение подхода выходит за пределы экономии электричества. Перспективным выглядит пилот в существующей инфраструктуре с измерением фактической мощности, а не только расчётных графиков.
“exhibiting flexibility up to 16% of total power consumption, with 90% of the desired power reduction achieved within approximately 10 seconds.”Creating Power Flexibility in Datacenters via Query Routing
Возможности
- Разработка механизмов участия ИИ-центров в программах управления спросом энергосетей.
- Пилоты с измерением реального потребления и качества обслуживания при динамическом распределении запросов.
Ограничения
- Результат крупного центра получен на имитации по трассам, а не на полном промышленном объекте.
- Изменение маршрутизации может повышать задержки, влиять на SLA и вступать в конфликт с требованиями размещения данных.
Исследование впервые представлено 3 ноября 2026 года. В выпусках 30 октября — 3 ноября аналогичная система регулирования мощности через маршрутизацию запросов не упоминалась; в отличие от новости DOE о финансировании сетевых компонентов это техническая модель спроса самого дата-центра.
Робототехника: программный агент создаёт тренировочные демонстрации
Авторы PyRUA-DataFarm сообщают, что на пяти реальных задачах политики, обученные на сгенерированных данных, показали 93 успешных попытки из 100 против 84 при обучении на сопоставимом числе теледемонстраций.
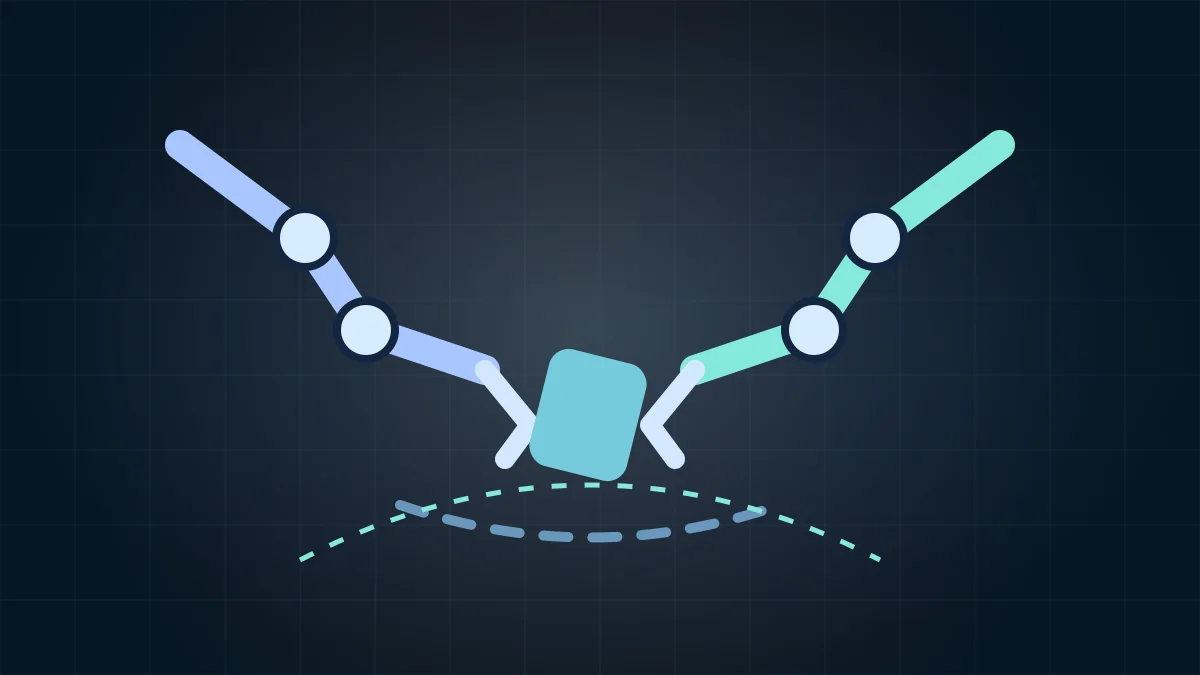
Исследователи из Пекинского университета и NVIDIA представили PyRUA-DataFarm — систему, в которой программный агент по одной калибровочной записи физического робота создаёт задачу в симуляторе, управляющий алгоритм и критерий успешности. Симулятор определяет действия и физические состояния, а генерация видео переносит их на реалистичные изображения исходной среды и одновременно формирует согласованные виды камер. Важная деталь — независимые проверки отделяют создание примеров от их допуска в набор данных.
Авторы сообщают об испытаниях на пяти задачах реального двурукого робота. В одной сводной оценке политики, обученные только синтетическими примерами DataFarm, добились 93 успешных попыток из 100 против 84 у политик, обученных на сопоставимом количестве примеров телеуправления. Эти цифры относятся к конкретной экспериментальной постановке; они не означают, что синтетические данные уже универсально лучше человеческих демонстраций.
Если подход переносится на более широкий класс задач, производители роботов смогут быстрее собирать обучающие примеры для новых объектов, ракурсов и условий, не занимая реальный манипулятор на каждый эпизод. Но DataFarm зависит от качества симулятора: масса, трение и сложный контакт не извлекаются достоверно из одного ролика. Поэтому промышленная перспектива — гибридный цикл: небольшая реальная калибровка, масштабирование в симуляции, затем обязательная проверка на настоящем оборудовании.
“policies trained only on farm data match policies trained on as many teleoperated episodes (93 vs. 84 successes in 100 trials)”PyRUA-DataFarm: LLM Agent as a Cost-Efficient Teleoperator for Real-Ready Robot Data
Возможности
- Подготовка обучающих наборов для новых сценариев манипулирования без телеуправления каждым эпизодом.
- Создание проверяемого конвейера synthetic-to-real с независимой оценкой допустимости данных.
Ограничения
- Эксперимент ограничен одним типом двурукого робота и пятью задачами.
- Симулятор не восстанавливает неизвестные физические параметры из одного калибровочного эпизода; синтетические видео могут содержать незамеченные ошибки.
Первое сообщение о DataFarm датировано 3 ноября 2026 года. В доступных выпусках 30 октября — 3 ноября рассматривались RoboArchitect и восстановление гуманоида после падения, но не автоматическое построение полноценных тренировочных демонстраций по одной калибровке.
Антитела: поиск полезных мутаций с учётом биологической правдоподобности
Группа Нгуен представила iGC, двухэтапную модель формирования и отбора мутаций антител, и сообщает о более чем двукратном превосходстве над лучшей базовой моделью в предсказании позиций мутаций.
Команда Тао Нгуен представила iGC, вычислительную схему оптимизации антител, которая пытается воспроизвести два аспекта естественного созревания иммунного ответа. Сначала модель учится на родственных последовательностях B-клеток, чтобы предлагать правдоподобные варианты соматических мутаций. Отдельная система штрафов призвана не дать алгоритму искусственно завышать расчётную награду через повторение выгодных, но малоосмысленных замен.
В опубликованной оценке авторы утверждают, что первый этап более чем вдвое превосходит сильнейшую из выбранных базовых моделей в предсказании позиций мутаций. Это прежде всего вычислительный результат на исследовательских данных: публикация не устанавливает клиническую эффективность, производственную пригодность или универсальную способность создавать лучшие терапевтические антитела.
Для исследовательских групп это может сокращать число кандидатов, отправляемых на дорогостоящие лабораторные испытания, если прогнозы сохранят точность на новых антигенах. Критический следующий шаг — независимое экспериментальное измерение связывания, стабильности, экспрессии и нежелательных свойств предложенных антител. Без такого этапа говорить о лекарственном прорыве преждевременно.
“The mutation prior more than doubles the strongest baseline in mutation-site prediction.”iGC: Antibody Optimization via Reinforcement Learning over a Learned Somatic Hypermutation Prior
Возможности
- Сокращение объёма лабораторного скрининга за счёт более правдоподобных кандидатов для последующей проверки.
- Интеграция биологических закономерностей в обучаемый поиск белковых последовательностей.
Ограничения
- Оценка носит вычислительный характер и не подтверждает эффективность кандидатов in vitro или in vivo.
- Оптимизация предсказанной награды может не соответствовать стабильности, безопасности и производимости реальных белков.
Препринт iGC размещён 3 ноября 2026 года; в выпусках 30 октября — 3 ноября эта технология не упоминалась. Ранее освещённые D2ML и Co²ODE решают другие задачи — селективность малых молекул и динамика биохимических сетей.
Шифрованные вычисления: единый стек для конфиденциального вывода моделей
Дзирилли и соавторы представили Perseus, библиотеку для полного конвейера вычислений над зашифрованными данными, и привели замеры моделей Llama-3-8B, GPT-2, BERT и ViT в оговорённых конфигурациях.
Алессандро Дзирилли и соавторы описали Perseus — доступную для исследований программную систему, которая соединяет криптографические операции, упаковку зашифрованных данных и выполнение нейросетей в одном стеке. Задача полностью гомоморфного шифрования состоит в том, чтобы сервер мог выполнять вычисления над данными, не получая их в открытом виде. Perseus пытается уменьшить издержки сразу на нескольких уровнях: восстановление части ключевых данных при исполнении, более плотная упаковка и более удачное размещение дорогостоящих операций обновления шифротекста.
Авторы приводят замеры на ряде моделей, включая Llama-3-8B, GPT-2, BERT и компьютерное зрение, и заявляют ускорение отдельных режимов относительно известных реализаций. Это сравнение авторов в оговорённых конфигурациях, а не подтверждение практической скорости обычного интерактивного чат-бота с полным шифрованием. В тексте работы прямо отмечено, что современное гомоморфное исполнение больших языковых моделей всё ещё далеко от привычной эксплуатации.
Перспектива Perseus — ускорить исследование конфиденциальных вычислений за счёт повторно используемой инженерной базы. Но до промышленных сценариев остаются вопросы производительности на длинных последовательностях, затрат на GPU, характеристик схемы безопасности и условий лицензирования при коммерческом использовании.
“We present Perseus, a free and open Python software library that supports the full stack of encrypted model inference”Perseus: A Full-Stack System for Homomorphic Model Inference
Возможности
- Более воспроизводимые испытания технологий конфиденциального вывода моделей на общедоступном программном стеке.
- Проверка вычислений над чувствительными данными без раскрытия их оператору сервиса в будущих специализированных системах.
Ограничения
- Полностью гомоморфное выполнение крупных моделей по-прежнему имеет значительную задержку и ресурсоёмкость.
- Условия коммерческого использования требуют отдельного изучения: исходная работа описывает исследовательскую доступность, а не неограниченную коммерческую лицензию.
Исследование Perseus опубликовано 3 ноября 2026 года. В выпусках 30 октября — 3 ноября отдельно обсуждались аппаратные GPU-бенчмарки и риски инструментов агентов, но не полный стек FHE-инференса.
Атака на параметры: агент выполняет нужное действие, но с чужим адресатом
Авторы AuthorityFlow исследовали подмену аргументов разрешённых инструментов и сообщили, что в их FactAuthBench защита снизила успех атак с 93,06% до 9,03%.
Яо Ван и соавторы выделили форму косвенной инъекции инструкций, при которой злоумышленнику не нужно заставлять агента выполнять неожиданное действие. Вместо этого он изменяет параметр уже ожидаемой операции: например, подставляет иной адрес получателя или значение в служебное поле. Такой вариант особенно опасен потому, что обычный журнал действий выглядит правдоподобно: агент пользуется разрешённым инструментом и продолжает решать задачу, но отправляет сведения не туда или изменяет не тот объект.
Предложенная защита AuthorityFlow для каждого параметра оценивает, какие источники информации вправе определять его значение в контексте запроса пользователя. На собственном тестовом наборе FactAuthBench они сообщают о снижении доли успешных атак с 93,06% до 9,03% при сохранении части полезности системы для обычных задач. Эти цифры не являются независимой оценкой универсальной защиты от инъекций в любых агентных системах.
Для организаций практический вывод состоит в том, что подтверждать нужно не только сам вызов инструмента, но и происхождение каждого критичного аргумента. Адреса отправки, идентификаторы клиентов, банковские реквизиты, пути удаления и права доступа должны выводиться из авторитетных данных, а не из текста, найденного на произвольной странице. Ограничения метода — ошибочно заданная иерархия источников, неоднозначные пользовательские поручения и новые способы обойти проверку в многошаговых процессах.
“Without defense, the attack success rate reaches 93.06%. AuthorityFlow reduces it to 9.03%”Right Tool, Wrong Parameters: Defending LLM Agents Against Parameter Poisoning
Возможности
- Добавление проверки происхождения критичных параметров перед отправкой писем, финансовыми операциями и изменениями CRM.
- Разработка политик доступа на уровне аргументов инструментов, а не только на уровне типов действий.
Ограничения
- Метрики получены в предложенном авторами тестовом наборе и не гарантируют защиты в эксплуатации.
- Ошибки назначения доверенных источников или неочевидные зависимости параметров могут приводить к ложным разрешениям либо отказам.
Новый препринт от 3 ноября 2026 года рассматривает именно подмену параметров допустимого вызова. В выпуске 2 ноября обсуждался SecPO, а 3 ноября — PrivacyTrace; они касались соответственно обучения против инъекций и утечек профиля, но не AuthorityFlow/FactAuthBench.
Источники
- You don't need long context03.11.2026
- Creating Power Flexibility in Datacenters via Query Routing03.11.2026
- PyRUA-DataFarm: LLM Agent as a Cost-Efficient Teleoperator for Real-Ready Robot Data03.11.2026
- iGC: Antibody Optimization via Reinforcement Learning over a Learned Somatic Hypermutation Prior03.11.2026
- Perseus: A Full-Stack System for Homomorphic Model Inference03.11.2026
- Right Tool, Wrong Parameters: Defending LLM Agents Against Parameter Poisoning03.11.2026